
الخلاصة: أهم تغير في AI Benchmarks هذا الأسبوع هو أن قراءة «من يتصدر؟» أصبحت أكثر تعقيدًا. GPT-6 Astra يتصدر Epoch Capabilities Index العام عند نحو 166 ويحقق Math-ECI يقارب 170، لكن Claude Fable 5.1 يتقدم في SWE-ECI الخاص بهندسة البرمجيات بنحو 167 مقابل 164 لأسترا. وفي الوقت نفسه، يعطي FrontierSWE v2 — وهو Benchmark مختلف طويل المدى — أسترا 65.5% مقابل 56.3% لـFable 5.1. هذه النتائج لا تتناقض؛ بل تقيس مجموعات مهام ومنهجيات مختلفة.
لذلك لا يوجد «أفضل نموذج مطلقًا» من هذه البيانات. القرار الصحيح يعتمد على نوع المهمة، Benchmark version، agent harness، reasoning effort، الأدوات، بيئة التنفيذ، التكلفة، والمدة المتاحة للمهمة.
ما الذي تغير فعليًا هذا الأسبوع؟
في 16 سبتمبر 2026 نشر Epoch AI تحليلًا محدثًا لنتائج GPT-6 Astra وClaude Fable 5.1 بعد وصول بيانات إضافية. التحديث مهم لأن نتيجة Astra العامة هبطت من تقدير إطلاق يقارب 169 إلى 166 بعد إضافة اختبارات software engineering، بينما ارتفعت Fable 5.1 من نحو 163 إلى 164.5. هذا مثال مباشر على سبب عدم التعامل مع نتيجة الإطلاق كرقم ثابت.
Epoch Capabilities Index: Astra أولًا إجمالًا لكن Fable أقوى في SWE-ECI
| النموذج | General ECI | Math-ECI | SWE-ECI |
|---|---|---|---|
| GPT-6 Astra | 166.31 | 169.83 | 163.58 |
| Claude Fable 5.1 | 164.47 | 165.73 | 167.44 |
| GPT-5.6 Sol | 161.81 | 162.76 | 160.47 |
| Kimi K3 | 157.63 | 158.39 | 161.54 |
الأهم من ترتيب الجدول هو عدم تجاهل فترات الثقة. Epoch يوضح أن نطاقات الثقة 90% لأسترا وFable 5.1 تتداخل في المقاييس الثلاثة. كما أن domain-specific ECI مبني حاليًا على عدد صغير نسبيًا من النتائج: 3 إلى 6 Benchmarks لكل نطاق، ولذلك لا يصح تحويل فارق بضع نقاط إلى حكم قطعي.
Math-ECI وSWE-ECI ليسا درجات نجاح مباشرة مثل pass@1؛ إنهما مقاييس نسبية مشتقة من منهجية ECI. لذلك لا نخلط 167 في SWE-ECI مع 65.5% في FrontierSWE v2 أو 59.1% في Terminal-Bench v4.0.
FrontierSWE v2: اختبار برمجة طويل المدى يغير زاوية المقارنة
FrontierSWE v2 هو التطور الأكثر أهمية لمتابعي Coding Agents هذا الأسبوع. الإصدار الحالي في سبتمبر 2026 يضم 34 مهمة من مجالات implementation وperformance engineering وscientific computing وvisual reasoning وAI research. كل نموذج يُشغّل خمس مرات لكل مهمة، مع ميزانية تصل إلى 20 ساعة للمحاولة، داخل agent harness موحد اسمه proximus وبأقصى reasoning effort.
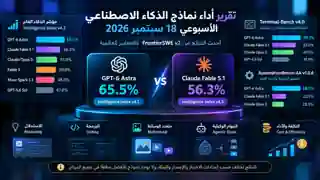
| النموذج | FrontierSWE v2 mean@5 | الـharness |
|---|---|---|
| GPT-6 Astra | 65.5% | proximus |
| Claude Fable 5.1 | 56.3% | proximus |
| GLM-5.3 | 30.2% | proximus |
| Kimi K3 | 25.9% | proximus |
| Grok 4.6 | 25.3% | proximus |
الرقم الرئيسي هنا هو mean@5: متوسط نتائج خمس محاولات عبر جميع المهام. الموقع يعرض أيضًا best@5 وworst@5 والتكلفة والوقت. هذا يجعل FrontierSWE أقرب إلى قياس تحمل الوكيل لمشروعات طويلة ومعقدة من Benchmark قصير قائم على سؤال/إجابة.
لماذا يتقدم Fable في SWE-ECI بينما يتقدم Astra في FrontierSWE؟
لأنهما ليسا الاختبار نفسه. SWE-ECI يجمع عدة Benchmarks هندسية ويعيد تقدير القدرة النسبية للنموذج. وفق بيانات Epoch الحالية، Astra يعتمد في SWE-ECI على MirrorCode وWeirdML وDeepSWE وFrontierCode، بينما Fable 5.1 لديه MirrorCode وWeirdML وFrontierCode. أما FrontierSWE v2 فهو Benchmark منفصل ذو 34 مهمة طويلة المدى وharness خاص به.
هذه النقطة مهمة عند شراء API أو اختيار نموذج لوكيل برمجي: لا تختَر بناءً على عمود واحد. اختبر مستودعاتك الفعلية، مدة المهام، tool permissions، معدل نجاح CI، تكلفة المهمة، ومعدل الحاجة إلى تدخل بشري.
Reasoning: Astra قوي في الرياضيات لكن الثقة الإحصائية مهمة
أقوى إشارة reasoning جديدة من Epoch هي Math-ECI: Astra عند 169.83 مقابل 165.73 لـFable 5.1. لكن كلاهما يعتمد على أربعة Benchmarks رياضية فقط في هذا snapshot، وفترات الثقة متداخلة. لذلك الصياغة الدقيقة هي أن Astra يتصدر التقدير الحالي للـMath-ECI، وليس أنه أثبت تفوقًا مطلقًا في كل أشكال reasoning.
Agentic Tasks: ماذا نفعل بنتائج الأسبوع السابق؟
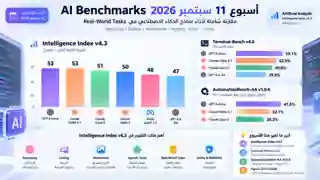
نتائج Artificial Analysis v4.3 من الأسبوع السابق ما زالت مفيدة، لكنها ليست تحديثًا جديدًا لهذا الأسبوع. كان GPT-6 Astra وClaude Fable 5.1 متعادلين عند 53 على Intelligence Index v4.3، مع فروق في Terminal-Bench v4.0 وAutomationBench-AA والتكلفة. لا نعيد دمج هذه الأرقام مع FrontierSWE أو ECI في «درجة موحدة» لأن منهجية كل نظام مختلفة.
لمن يريد تفاصيل النموذج نفسه بدل التقرير المقارن، راجع تحليل Claude Fable 5.1. وللتقرير السابق الذي شرح انتقال Artificial Analysis إلى v4.3، هذه الصفحة نفسها تحتفظ بسياق الأسبوع الماضي عبر تاريخ التعديل بدل إنشاء مقال منافس جديد.
Multimodal: لا يوجد تحديث هذا الأسبوع يبرر ترتيبًا موحدًا جديدًا
راجعت لوحات multimodal الحديثة، لكن لم أجد هذا الأسبوع تغييرًا موثوقًا يسمح بدمج image/video evaluation مع نتائج ECI أو FrontierSWE في ترتيب واحد. لذلك لا أضع «درجة multimodal» مصطنعة داخل الجدول. Benchmarks الصور غالبًا تستخدم Elo أو تفضيلات بشرية، بينما coding benchmarks تستخدم نجاح تنفيذ مهام أو rewards مختلفة جذريًا.
كيف تختار نموذجًا عمليًا من هذه النتائج؟
- للمهام البرمجية الطويلة: استخدم FrontierSWE v2 كإشارة، ثم اختبر نموذجك على مستودعاتك وCI الفعلي.
- للرياضيات والاستدلال: راقب Math-ECI والـbenchmarks الأصلية بدل الاعتماد على ECI العام وحده.
- للوكلاء: قِس success rate مع الأدوات والصلاحيات الفعلية، لا النموذج الخام فقط.
- للتكلفة: احسب cost per successful task، لا سعر المليون token فقط.
- للـmultimodal: استخدم Benchmark متخصصًا في modality المطلوبة ولا تدمجه حسابيًا مع coding/reasoning دون منهجية معلنة.
حدود هذا التقرير
نتائج Benchmarks تتغير مع وصول runs جديدة، وقد يتغير ترتيب ECI عند إضافة اختبارات. Epoch نفسها توضح أن نتيجة Astra تحركت بعد زيادة عدد software engineering benchmarks. كذلك لا تتساوى نتائج vendor evals مع independent evals إذا اختلف harness أو prompting أو reasoning budget. لهذا أذكر الإصدار والمنهجية وأتعامل مع كل جدول داخل نطاقه فقط.
المصادر الأصلية
- Epoch AI — GPT-6 Astra leads on math benchmarks, but not on software engineering، 16 سبتمبر 2026.
- FrontierSWE v2 — Leaderboard والمنهجية.
- Epoch AI — FrontierSWE v2 methodology.
- Artificial Analysis — Intelligence Benchmarking methodology v4.3.1.
أسئلة شائعة
هل GPT-6 Astra هو أفضل نموذج ذكاء اصطناعي حاليًا؟
لا يمكن إثبات ذلك من Benchmark واحد. Astra يتصدر ECI العام الحالي وFrontierSWE v2، بينما Fable 5.1 يتقدم في SWE-ECI. اختيار الأفضل يتغير حسب المهمة والمنهجية والتكلفة.
لماذا تختلف نتائج Benchmarks لنفس النموذج؟
لأن Benchmark version وagent harness وreasoning effort والأدوات وprompting وبيئة التنفيذ ووقت المهمة قد تختلف. المقارنة الصحيحة تتطلب توحيد هذه المتغيرات قدر الإمكان.
ما أهم Benchmark للبرمجة هذا الأسبوع؟
FrontierSWE v2 مهم لأنه يختبر 34 مهمة طويلة المدى بخمس محاولات وميزانية تصل إلى 20 ساعة لكل محاولة، لكنه لا يلغي قيمة MirrorCode أو DeepSWE أو Terminal-Bench؛ كل منها يقيس زاوية مختلفة.
